PDF till bild eller text: välj rätt arbetsgång
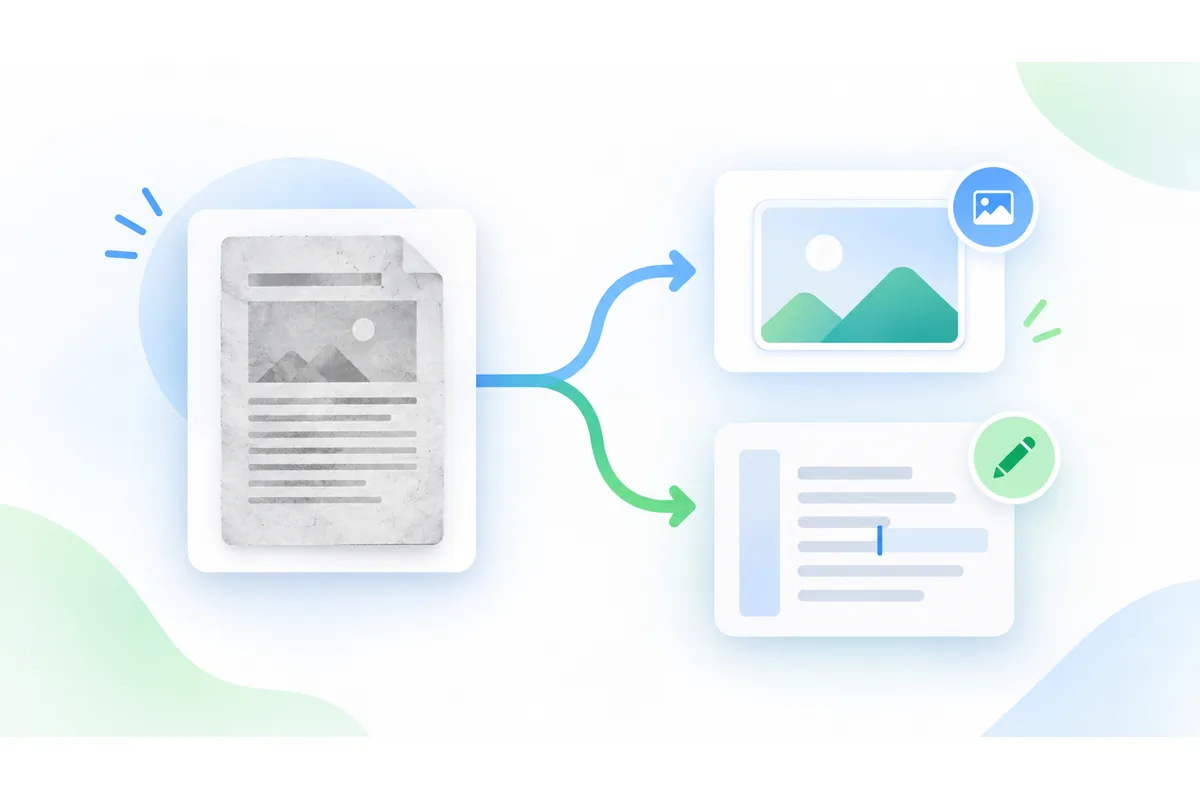
En bild av PDF-sidan, ett inbäddat originalfoto och redigerbar text är olika resultat. Välj den åtgärd som faktiskt ger det du behöver.
Av Abdul BasitPublicerad Uppdaterad 4 min läsning
I korthet
- PDF till JPG och PNG renderar hela sidan.
- Välj bara de sidor och den upplösning som behövs.
- En bildkonvertering ger inte en skannad PDF ett sökbart textlager.
- För skannad text exporterar du PNG och använder sedan OCR med rätt språk.
En PDF kan innehålla textobjekt, vektorer och foton eller enbart skannade bilder. Prova först att markera texten i en PDF-läsare; den kanske redan går att kopiera.
Verktygen bearbetar filer lokalt för avgränsade uppgifter. De ersätter inte en fullständig PDF-textredigerare, säker maskning eller en tjänst för digitala signaturer.
Bestäm vad resultatet ska innehålla
| Mål | Lämplig åtgärd | Vad som inte skapas |
|---|---|---|
| Hel sida i fotoformat | PDF till JPG | Oförändrat inbäddat originalfoto |
| Text- eller grafiksida som bild | PDF till PNG | Sökbart textlager |
| Kopierbar text från skanning | PNG-export och OCR | Word med bevarad layout |
| Bara vissa sidor | Dela PDF | Rasterbild av sidan |
Om PDF fungerar som slutformat kan du undvika onödig rasterisering. Dela PDF eller Ordna PDF-sidor kan skapa dokumentet utan att göra sidinnehållet till pixlar.
Välj JPG eller PNG för sidan
PDF till JPG passar ofta fotografiska sidor och mindre filer. JPEG-komprimering kan ändra liten text och skarpa kanter. PDF till PNG undviker det förstörande steget men kan ta mer plats.
Båda verktygen renderar hela sidan mot vitt och skapar en bild per vald sida. De plockar inte ut ett inbäddat foto i dess ursprungliga upplösning eller komprimering.
Välj en användbar upplösning
Du kan välja 72, 144, 216 eller 288 dpi. En liten förhandsvisning kan behöva färre pixlar än liten text eller OCR. Prova en sida innan du exporterar ett stort urval.
Dubblerad upplösning ger ungefär fyra gånger fler pixlar och kräver mer minne. Varje renderad sida begränsas till 16 miljoner pixlar; stort pappersformat kan kräva lägre dpi.
Högre exportupplösning återskapar inte detaljer som saknas i en suddig skanning. Ett bättre original kan hjälpa mer.
Välj sidor och behåll ordningen
Skriv 1-3, 5 för fyra sidor. Med 5, 1 exporteras sidorna i den ordningen. Tomt fält betyder alla; numren måste finnas i dokumentet.
Varje körning stöder högst 50 valda sidor. Dela större arbeten i mindre intervall och ladda ner resultaten innan du fortsätter. Bilder kan laddas ned separat eller tillsammans som ZIP. Sidorna fogas inte samman till en lång bild.
Läs text från en skannad sida
- Kontrollera om PDF-filen redan har markerbar text.
- Exportera annars den aktuella sidan som ett tillräckligt skarpt PNG.
- Öppna Bild till text och välj PNG-filen.
- Välj dokumentets språk: svenska för svensk text.
- Kör OCR och granska accenter, namn, siffror och radbrytningar.
- Kopiera den rättade texten eller ladda ner TXT.
OCR känner igen tecken men bedömer inte innehållets riktighet. Tabeller och spalter kan få fel läsordning. Resultatet är vanlig text, inte ett formaterat Word-dokument eller ett nytt sökbart PDF-lager.
Rätta suddiga PDF-bilder och OCR-fel
Testa en sida innan du bearbetar hela dokumentet. Om liten text är svårläst, jämför 216 eller 288 dpi med 72 eller 144 dpi. Högre exportupplösning återskapar inte detaljer som saknas i en suddig skanning.
Om tecken känns igen fel, kontrollera sidans riktning och språkvalet. Exportera den sida du behöver, beskär bilden till textområdet och kör OCR igen. Jämför namn, datum och siffror med originalet; ett konfidensvärde garanterar inte korrekt text.
Behåll original och granska känsliga uppgifter
Lokal bearbetning undviker uppladdning genom verktygen. Den intygar inte att filen saknar känsliga metadata eller lämpar sig att dela. Spara originalet och dela bara det som behövs.
Lösenordsskyddade PDF-filer öppnas inte här. En PDF-vattenstämpel är en synlig märkning, inte kryptering. Använd Bilder till PDF för bildsidor och formatguiden för val av bildtyp.
För storleksgränser efter export, läs komprimeringsguiden.
Vanliga frågor
- Kan jag konvertera PDF direkt till TXT?
- OCR tar emot bildfiler. För en skanning exporterar du först PDF-sidan till PNG. Om texten redan går att markera kan det vara enklare att kopiera den i PDF-läsaren.
- Är PDF till PNG förlustfritt?
- PNG sparar de renderade pixlarna utan förstörande bildkomprimering. Renderingen gör ändå text och vektorer till ett begränsat pixelrutnät, så PDF-strukturen kopieras inte identiskt.
- Varför kan jag inte markera text efter PDF till JPG?
- JPG-filen innehåller pixlar i stället för textobjekt. Behåll PDF för dokumentfunktionerna eller använd OCR om du bara har bilden kvar.
- Kan jag bearbeta mer än 50 sidor?
- Ja, i separata körningar med högst 50 valda sidor vardera. Välj rimliga intervall och ladda ner varje grupp innan du fortsätter.
- Kan jag göra en skannad PDF till ett redigerbart Word-dokument här?
- Exportera sidan som PNG, läs texten med OCR och klistra in den granskade texten i Word. Nedladdningen är TXT, inte DOCX. Tabeller, spalter och layout behöver formateras manuellt. PDF-filen får inget nytt sökbart textlager.
Om författaren
Abdul Basit
Abdul Basit driver QuickImageFix och skriver guiderna om bildkomprimering, storleksändring, formatkonvertering och PDF-uppgifter. Guiderna förklarar webbplatsens verktyg och de val som påverkar resultatet.
Läs författarprofilen