PDF en image ou en texte : choisir la bonne opération
Une image de la page, une photo originale intégrée au PDF et du texte modifiable sont trois résultats différents. Choisissez l’opération selon votre besoin.
Par Abdul BasitPublié le Mis à jour le 4 min de lecture
En bref
- PDF en JPG et PDF en PNG représentent la page entière.
- Choisissez seulement les pages et la résolution nécessaires.
- Transformer un scan en image n’ajoute pas de texte recherchable.
- Pour lire un scan, exportez une page en PNG puis utilisez l’OCR dans la bonne langue.
Un PDF peut contenir du texte, des vecteurs et des photos, ou uniquement des pages scannées. Essayez d’abord de sélectionner le texte dans un lecteur : il est peut-être déjà copiable.
Les fichiers sont traités localement pour des tâches précises. Ces outils ne remplacent ni un éditeur complet de texte PDF, ni un système de caviardage sécurisé, ni un service de signature numérique.
Définir le résultat attendu
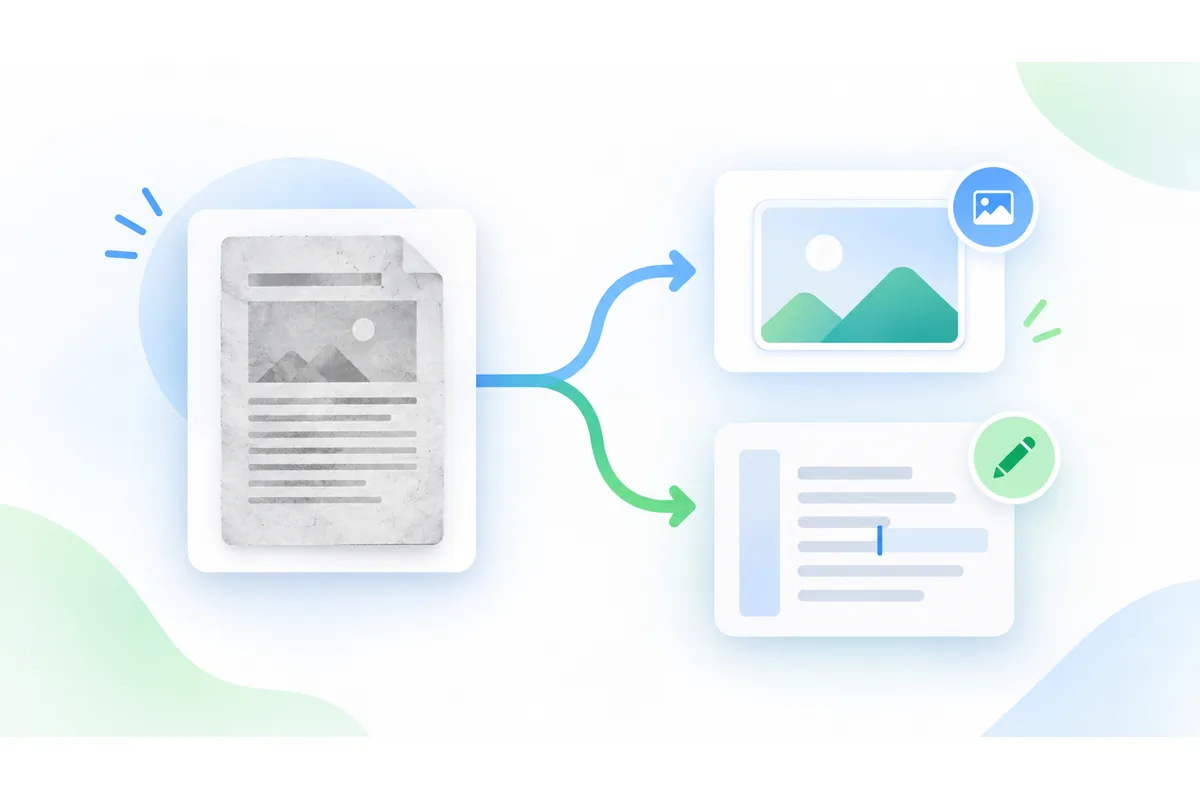
| Besoin | Opération adaptée | Ce qui n’est pas créé |
|---|---|---|
| Page entière en format photo | PDF en JPG | Photo originale intégrée sans modification |
| Page de texte ou graphique en image | PDF en PNG | Couche de texte recherchable |
| Texte copiable depuis un scan | Export PNG puis OCR | Document Word conservant la mise en page |
| Quelques pages seulement | Diviser le PDF | Image matricielle de la page |
Si vous pouvez conserver le PDF, évitez une conversion inutile en pixels. Diviser un PDF ou Organiser les pages peut préparer le document sans le rasteriser.
Choisir JPG ou PNG pour une page
PDF en JPG convient souvent aux pages photographiques et au partage compact. La compression JPEG peut altérer les petits caractères. PDF en PNG évite cette étape avec perte, mais peut peser davantage.
Les deux outils dessinent la page complète sur blanc et créent une image par page choisie. Ils n’extraient pas une photo intégrée dans sa résolution ou sa compression d’origine.
Choisir une résolution utile
Les réglages proposés sont 72, 144, 216 et 288 ppp. Une petite prévisualisation peut demander moins de pixels que des caractères fins ou une entrée OCR. Testez une page avant une longue sélection.
Doubler la résolution quadruple environ le nombre de pixels et augmente la mémoire nécessaire. Chaque page rendue est limitée à 16 millions de pixels ; les grands formats peuvent nécessiter moins de ppp.
Une résolution de sortie plus élevée ne recrée pas les détails absents d’un scan flou. Une meilleure source peut être plus utile.
Sélectionner les pages dans le bon ordre
Saisissez 1-3, 5 pour quatre pages. Avec 5, 1, elles sortent dans cet ordre. Un champ vide sélectionne tout ; les numéros doivent exister.
Chaque traitement accepte au plus 50 pages sélectionnées. Découpez les longues tâches en plages raisonnables et téléchargez les résultats avant de continuer. Les images se téléchargent séparément ou ensemble en ZIP. Les pages ne sont pas assemblées en une seule image.
Reconnaître le texte d’un scan
- Vérifiez si le PDF contient déjà du texte sélectionnable.
- Sinon, exportez la page utile en PNG suffisamment net.
- Ouvrez Image en texte et choisissez le PNG.
- Choisissez la langue du document : français pour un texte en français.
- Lancez l’OCR et relisez accents, noms, chiffres et sauts de ligne.
- Copiez le texte corrigé ou téléchargez-le en TXT.
L’OCR reconnaît les caractères sans valider leur sens. Les tableaux et colonnes peuvent ressortir dans un ordre différent. Il produit du texte brut, pas un Word mis en page ni une nouvelle couche recherchable dans le PDF.
Corriger un export flou ou des erreurs d’OCR
Testez une page avant de traiter tout le document. Si les petits caractères sont illisibles, comparez 216 ou 288 dpi à 72 ou 144 dpi. Augmenter la résolution ne recrée pas les détails absents d’un scan flou.
Si des caractères sont mal reconnus, vérifiez l’orientation et la langue. Exportez la page utile, recadrez l’image sur le texte et relancez l’OCR. Comparez noms, dates et chiffres à l’original : le score de confiance ne garantit pas leur exactitude.
Garder les originaux et contrôler les informations sensibles
Le traitement local évite l’envoi des fichiers par ces outils. Il ne certifie pas l’absence de métadonnées sensibles ni l’adéquation du document au partage. Gardez l’original et ne transmettez que le nécessaire.
Les PDF protégés par mot de passe ne s’ouvrent pas ici. Un filigrane PDF est un repère visible, pas un chiffrement. Utilisez Images en PDF pour réunir des pages et le guide des formats pour choisir le type d’image.
Pour respecter une limite de poids après l’export, consultez le guide de compression.
Questions fréquentes
- Puis-je convertir directement un PDF en TXT ?
- L’OCR lit des images. Pour un scan, exportez d’abord la page PDF en PNG. Si le texte est déjà sélectionnable, le copier depuis le lecteur peut être plus simple.
- PDF en PNG est-il sans perte ?
- Le PNG enregistre sans perte les pixels rendus. Le rendu transforme néanmoins texte et vecteurs en une grille finie : ce n’est pas une copie identique de la structure PDF.
- Pourquoi le texte n’est-il plus sélectionnable après PDF en JPG ?
- Le JPG contient des pixels, pas des objets texte. Gardez le PDF pour ses fonctions documentaires ou utilisez l’OCR si seule une image est disponible.
- Puis-je traiter plus de 50 pages ?
- Oui, en plusieurs traitements limités chacun à 50 pages choisies. Utilisez des plages raisonnables et téléchargez chaque groupe avant de poursuivre.
- Peut-on transformer un PDF scanné en Word modifiable ici ?
- Exportez la page en PNG, reconnaissez le texte par OCR et collez le texte relu dans Word. Le téléchargement est en TXT, pas en DOCX. Tableaux, colonnes et mise en page demandent des retouches manuelles ; le PDF ne reçoit pas de couche recherchable.
À propos de l’auteur
Abdul Basit
Abdul Basit gère QuickImageFix et rédige ses guides sur la compression, le redimensionnement et la conversion d’images, ainsi que sur les tâches PDF. Les guides présentent les outils du site et les choix qui influencent les résultats.
Consulter le profil de l’auteur