PDF in immagini o testo: scegliere la conversione giusta
Un’immagine della pagina, una foto originale incorporata e un testo modificabile sono risultati diversi. Scegli il passaggio in base a quello che ti serve.
Di Abdul BasitPubblicato Aggiornato 4 min di lettura
I punti essenziali
- PDF in JPG e PDF in PNG rappresentano tutta la pagina.
- Seleziona solo le pagine e la risoluzione necessarie.
- Convertire una scansione in immagine non aggiunge testo ricercabile.
- Per leggere una scansione, esporta PNG e usa OCR con la lingua corretta.
Un PDF può contenere oggetti di testo, vettori e foto oppure soltanto immagini scansionate. Prova prima a selezionare il testo nel lettore PDF: potrebbe essere già copiabile.
Gli strumenti elaborano i file localmente per operazioni specifiche. Non sostituiscono un editor completo del testo PDF, una censura sicura dei contenuti o un servizio di firma digitale.
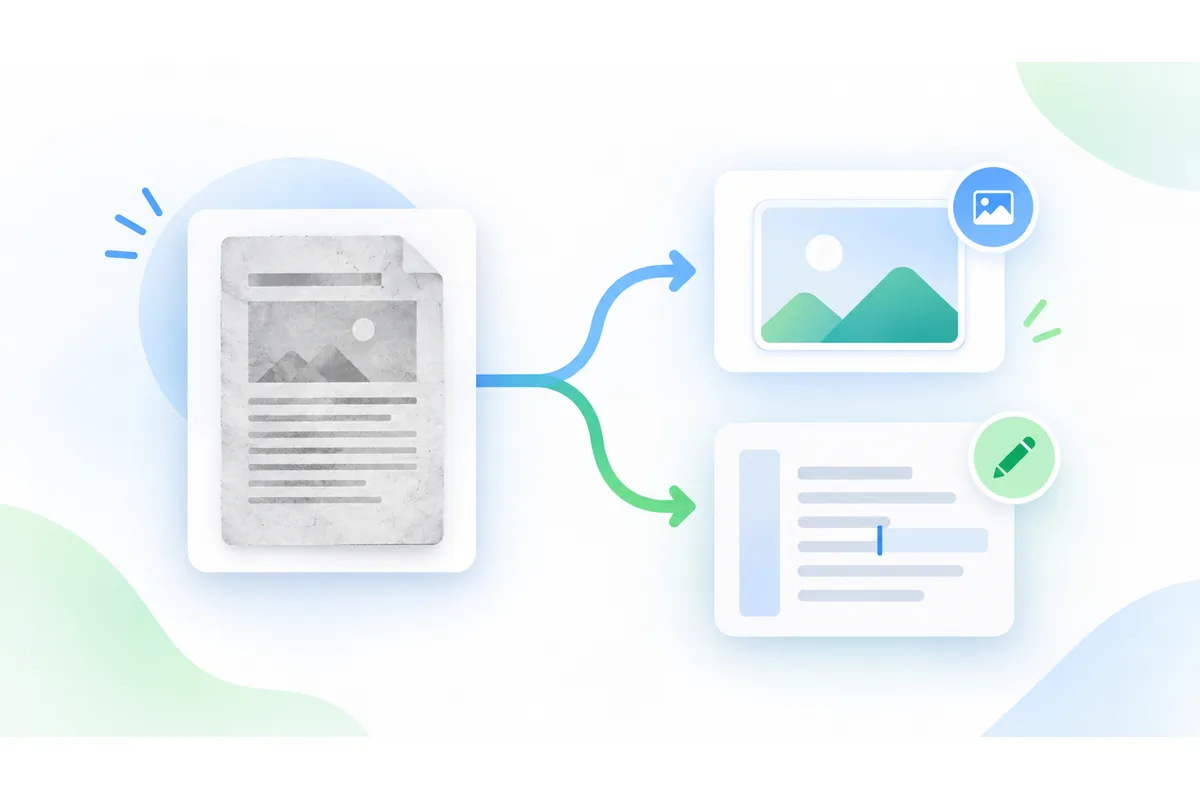
Decidere che cosa deve contenere il risultato
| Obiettivo | Operazione adatta | Cosa non viene creato |
|---|---|---|
| Pagina intera in formato fotografico | PDF in JPG | Foto originale incorporata senza modifiche |
| Pagina di testo o grafica come immagine | PDF in PNG | Livello di testo ricercabile |
| Testo copiabile da una scansione | Esportazione PNG e OCR | Word con impaginazione conservata |
| Solo alcune pagine | Dividi PDF | Immagine raster della pagina |
Se puoi mantenere il PDF, evita conversioni inutili in pixel. Dividi PDF o Organizza pagine PDF possono preparare il documento senza rasterizzarlo.
JPG o PNG per le pagine
PDF in JPG è spesso adatto a pagine fotografiche e condivisioni leggere. La compressione JPEG può alterare testo piccolo e bordi. PDF in PNG evita quel passaggio con perdita, ma può occupare più spazio.
Entrambi disegnano l’intera pagina su bianco e creano un’immagine per pagina selezionata. Non estraggono una foto incorporata alla risoluzione e compressione originali.
Scegliere una risoluzione utile
Sono disponibili 72, 144, 216 e 288 dpi. Una piccola anteprima può richiedere meno pixel di scritte minute o di un’immagine per OCR. Prova una pagina prima di esportarne molte.
Raddoppiare la risoluzione quadruplica circa i pixel e aumenta memoria e tempi. Ogni pagina renderizzata è limitata a 16 milioni di pixel: formati di carta grandi possono richiedere meno dpi.
Una risoluzione superiore non ricrea dettagli assenti in una scansione sfocata. Un originale più nitido può essere più utile.
Scegliere pagine e ordine
Scrivi 1-3, 5 per quattro pagine. Con 5, 1 vengono esportate in quell’ordine. Il campo vuoto indica tutte le pagine; i numeri devono esistere nel documento.
Ogni elaborazione ammette al massimo 50 pagine selezionate. Dividi i lavori lunghi in intervalli più piccoli e scarica i risultati prima di continuare. Le immagini si scaricano singolarmente o insieme in uno ZIP. Le pagine non vengono unite in una sola immagine.
Leggere il testo di una scansione
- Verifica se il PDF contiene già testo selezionabile.
- Altrimenti esporta la pagina richiesta come PNG sufficientemente nitido.
- Apri Immagine in testo e seleziona il PNG.
- Scegli la lingua del documento: italiano se il testo è in italiano.
- Avvia OCR e controlla accenti, nomi, numeri e interruzioni di riga.
- Copia il testo corretto o scaricalo in TXT.
OCR riconosce i caratteri, non verifica il significato. Tabelle e colonne possono uscire in un ordine diverso. Il risultato è testo semplice, non un Word impaginato, un foglio Excel ricostruito o un nuovo livello ricercabile nel PDF.
Correggere pagine sfocate ed errori OCR
Prova una pagina prima di elaborare tutto il documento. Se i caratteri piccoli non si leggono, confronta 216 o 288 dpi con 72 o 144 dpi. Aumentare la risoluzione di uscita non ricrea dettagli assenti da una scansione sfocata.
Se i caratteri vengono confusi, controlla orientamento e lingua. Esporta la pagina necessaria, ritaglia l’immagine sulla zona di testo e ripeti l’OCR. Confronta nomi, date e numeri con l’originale: il valore di confidenza non garantisce l’esattezza.
Conservare originali e controllare i dati riservati
L’elaborazione locale evita il caricamento dei documenti attraverso questi strumenti. Non certifica l’assenza di metadati sensibili o l’idoneità alla condivisione. Conserva l’originale e invia solo ciò che serve.
Qui non si aprono PDF protetti da password. Una filigrana PDF è un contrassegno visibile, non una cifratura. Usa Immagini in PDF per raccogliere pagine e la guida ai formati per scegliere il tipo di immagine.
Per i limiti di peso dopo l’esportazione consulta la guida alla compressione.
Domande frequenti
- Posso convertire un PDF direttamente in TXT?
- OCR accetta immagini. Per una scansione, esporta prima la pagina PDF in PNG. Se il testo è già selezionabile, copiarlo dal lettore PDF può essere più semplice.
- PDF in PNG è una conversione senza perdita?
- PNG salva senza compressione con perdita i pixel renderizzati. Il rendering converte però testo e vettori in una griglia finita, quindi non mantiene identica la struttura del PDF.
- Perché dopo PDF in JPG non riesco a selezionare il testo?
- Il JPG contiene pixel, non oggetti di testo. Conserva il PDF per le sue funzioni documentali oppure usa OCR quando hai soltanto l’immagine.
- Posso elaborare più di 50 pagine?
- Sì, in più esecuzioni con al massimo 50 pagine selezionate ciascuna. Usa intervalli gestibili e scarica ogni gruppo prima di proseguire.
- Posso trasformare un PDF scansionato in un Word modificabile qui?
- Esporta la pagina in PNG, estrai il testo con OCR e incolla il testo verificato in Word. Il download è TXT, non DOCX. Tabelle, colonne e impaginazione richiedono modifiche manuali; il processo non aggiunge un livello ricercabile al PDF.
Informazioni sull’autore
Abdul Basit
Abdul Basit gestisce QuickImageFix e scrive le guide su compressione, dimensioni, formati immagine e operazioni PDF. Gli articoli spiegano gli strumenti disponibili e le impostazioni che influenzano il risultato.
Leggi il profilo dell’autore