PDF를 이미지로 변환하고 한글을 추출하는 방법
PDF 페이지를 이미지로 저장하는 작업과 글자를 텍스트로 읽는 작업을 구분하세요. 필요한 페이지만 변환하면 작업도 가벼워집니다.
작성: Abdul Basit발행일 수정일 읽는 데 약 3분
핵심 내용
- PDF JPG·PNG 도구는 페이지 전체를 이미지로 만듭니다. 삽입된 사진의 원본 추출과 다릅니다.
- 변환은 한 번에 최대 50페이지입니다. 페이지가 크면 낮은 해상도나 작은 범위로 나누세요.
- 한글 추출은 페이지 이미지 → 한국어 OCR 순서이며 검색 가능한 PDF·DOCX 출력은 아닙니다.
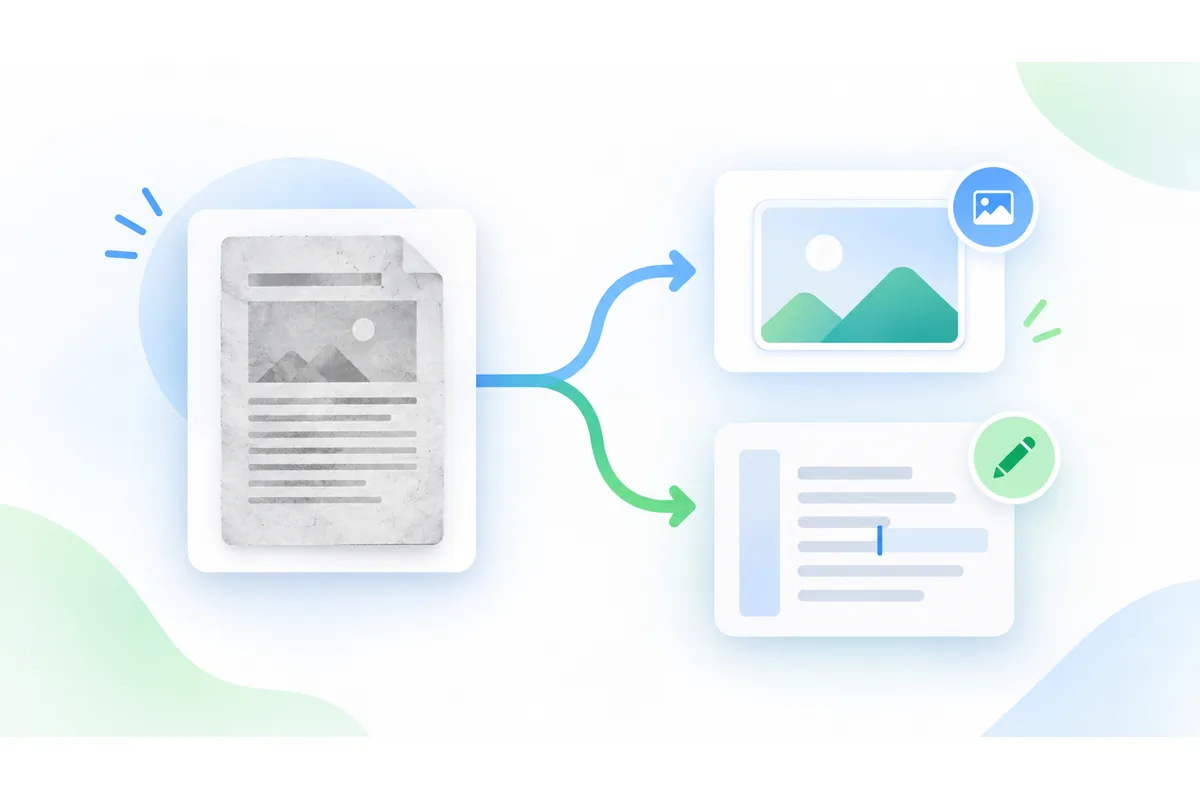
문서를 이미지로 제출하거나 스캔한 한글을 복사하려면 서로 다른 단계가 필요할 수 있습니다. 원본 PDF에서 텍스트를 선택할 수 있다면 우선 사용 중인 뷰어의 복사 기능을 확인하세요. 이미지로만 된 스캔에는 OCR이 필요합니다.
이 가이드는 PDF JPG, PDF PNG와 이미지 글자 추출을 연결합니다. HWP·HWPX는 직접 입력하지 못하므로 원래 프로그램에서 PDF로 내보내는 단계가 먼저 필요합니다.
필요한 결과에 따라 도구 선택
| 필요한 결과 | 기존 도구 | 주요 차이 |
|---|---|---|
| 사진·스캔을 PDF로 | [이미지 PDF 변환](image-to-pdf) | 이미지 1장당 페이지 1개 |
| PDF 페이지를 JPEG로 | [PDF JPG 변환](pdf-to-jpg) | 페이지 전체를 손실 JPEG로 저장 |
| 작은 글자를 PNG로 | [PDF PNG 변환](pdf-to-png) | 렌더링한 픽셀을 PNG로 저장 |
| 이미지 속 한글을 텍스트로 | [한글 OCR](image-to-text) | 인식 결과를 검토해 복사·TXT 저장 |
페이지 렌더링은 PDF의 텍스트와 도형을 픽셀로 바꿉니다. 문서 내부에 삽입된 사진의 원본 파일만 꺼내는 기능이 아닙니다.
페이지 범위와 해상도 정하기
범위를 비우면 전체 페이지를 선택합니다. 필요한 부분만 쓰려면 1-3, 8처럼 파일의 실제 페이지 위치를 입력하세요. 인쇄된 쪽수와 달리 표지가 1페이지일 수 있습니다. 중복 번호는 한 번만 처리하고 입력한 순서를 사용합니다.
한 번에 최대 50페이지, 페이지당 최대 1,600만 픽셀 범위에서 처리합니다. 배율 1×·2×·3×·4×는 PDF 좌표 기준 약 72·144·216·288dpi에 해당합니다. 페이지 크기와 배율이 크면 메모리 한도를 넘을 수 있으니 작은 범위와 낮은 배율부터 시작하세요.
JPG·PNG 결과 저장과 HWP 작업
사진 위주의 페이지는 JPG, 작은 글자와 선이 많은 페이지는 PNG를 비교해 보세요. JPG는 고정된 JPEG 품질로 저장하며 여기에는 별도의 품질 슬라이더가 없습니다. 필요하면 변환 후 JPG 압축을 사용하세요.
결과는 페이지별 이미지로 제공됩니다. 개별 파일이나 ZIP으로 다운로드한 뒤 누락 여부를 확인하세요. 페이지 안의 사진 원본만 추출하는 기능은 아닙니다.
hwp to jpg가 필요하다면 한글 문서 프로그램에서 PDF로 내보내고 그 PDF가 제대로 보이는지 먼저 확인하세요. 이후 PDF JPG 변환을 실행합니다. 내보내기 메뉴는 프로그램 버전마다 다를 수 있으며 이 사이트는 HWP·HWPX 자체를 읽지 않습니다.
이미지에서 한글 OCR 실행하기
페이지 편집과 텍스트 편집 구분하기
- PDF 합치기는 문서 단위로 이어 붙입니다.
- PDF 나누기는 선택한 페이지를 하나로 묶거나 입력한 범위마다 별도 PDF로 저장합니다. 범위를 비워 두면 전체 문서를 페이지별로 나눌 수 있습니다.
- PDF 회전과 페이지 정리는 방향·순서·삭제를 처리합니다.
- 페이지 번호는 기존 번호를 지우지 않고 새 번호를 추가합니다.
- 워터마크는 문구를 얹을 뿐 암호화·전자서명·보안 가림이 아닙니다.
이 도구들은 PDF 본문의 문장을 고치거나 Word·DOCX·HWP 파일로 바꾸지 않습니다. 이미지 OCR 결과도 일반 텍스트이며 원래 표나 레이아웃을 유지하는 검색 가능한 PDF는 아닙니다.
PDF 이미지가 흐리거나 OCR이 틀릴 때
문서를 제출하기 전 확인
자주 묻는 질문
- PDF의 사진만 고화질 원본으로 추출하나요?
- 아니요. 페이지 전체를 렌더링한 이미지입니다. 삽입된 원본 사진 파일을 분리하는 작업과 다릅니다.
- 스캔 문서를 검색 가능한 PDF로 만들 수 있나요?
- 현재 OCR 출력은 복사 가능한 일반 텍스트·TXT입니다. PDF에 텍스트 층을 넣거나 DOCX 문서를 생성하지 않습니다.
- 한국어 OCR이 틀리면 어떻게 하나요?
- 언어 선택, 원본 선명도와 기울기를 확인하세요. 이름, 금액, 날짜와 숫자는 직접 대조하고 수정해야 합니다.
- PDF 압축이나 암호 해제도 지원하나요?
- 지원하지 않습니다. 사진으로 새 PDF를 만들 때 이미지를 먼저 줄일 수는 있지만 기존 PDF의 압축이나 암호 제거 기능은 없습니다.
- 스캔 PDF를 편집 가능한 Word 파일로 바꿀 수 있나요?
- 페이지를 PNG로 저장하고 OCR로 추출한 글자를 확인한 뒤 Word에 붙여 넣을 수 있습니다. 다운로드는 DOCX가 아닌 TXT입니다. 표·단·페이지 배치는 직접 정리해야 하며 PDF에 검색 가능한 텍스트 층을 추가하지는 않습니다.
작성자 소개
Abdul Basit
Abdul Basit은 QuickImageFix를 운영하며 이미지 용량 줄이기, 크기 조절, 형식 변환과 PDF 작업 가이드를 작성합니다. 도구에서 선택할 수 있는 설정과 결과에 미치는 영향을 설명합니다.
작성자 프로필 보기